
"PythonスクリプトでMicrosoft SharePointにアクセスする方法について疑問に思われたことはありませんか?
このチュートリアルでは、それだけを扱っています。 Connect Bridgeというツールを使えば、簡単にできるようになります。
初出:2019年7月10日
最終更新日:2026年10月14日
要約
- 機能: Pythonスクリプトが、ODBCおよび
pyodbcモジュール。. - 方法: 商用ツールであるConnect Bridge(無料試用版あり)は、PythonとSharePointの間に位置し、SharePointのAPIをあたかもデータベースであるかのように提供します。.
- 必要なもの: Windowsマシン、Python 3、,
pyodbc, 、Connect Bridge(SharePointアカウントが設定済み)および、それによって生成されるODBC接続文字列。. - 内容: 約15行のコアスクリプトに加え、リストの作成、レコードの挿入、およびドキュメントのアップロードとダウンロードを行うためのSQLおよびストアドプロシージャの例。.
- 注意事項: Windows専用(著者によるテスト済み);商用ライセンス。.
- 最高だ: SQLで思考し、SharePoint APIを直接学ぶことを避けたいと考えているチーム。.
目次
序章
この記事では SharePointにPython接続, 、つまり、Pythonスクリプト内からMicrosoft SharePointシステム(2013、2016、2019、またはOnline)のデータにアクセスする方法です。データの転送はODBCレイヤーを介して行われます。.
更新に関する注記:この記事のサンプルは、もともと2019年から2022年にかけて、Python 3.7および パイodbcモジュール ver. 4.0.26。2026年10月、スクリプトを簡素化し、Python 3.14 および pyodbc 5.3.0 に対応するようエラー処理を書き直しました。お使いの環境で動作が異なる場合は、コメント欄でお知らせください。.
ここで注意したいのは、この記事ではConnect Bridgeという市販品を使用していることです。これは実は、SharePoint側をいじっていないことを確信した上でデータ通信を可能にすることで、Python / SharePointの連携を可能にしているのです(そして、信じてください、これは非常に重要です)。あなたは以下のことができます。 無料体験を受ける Connect Bridge用なので、全部自分で試してみてください。
この「Connect Bridge」とは何でしょうか?
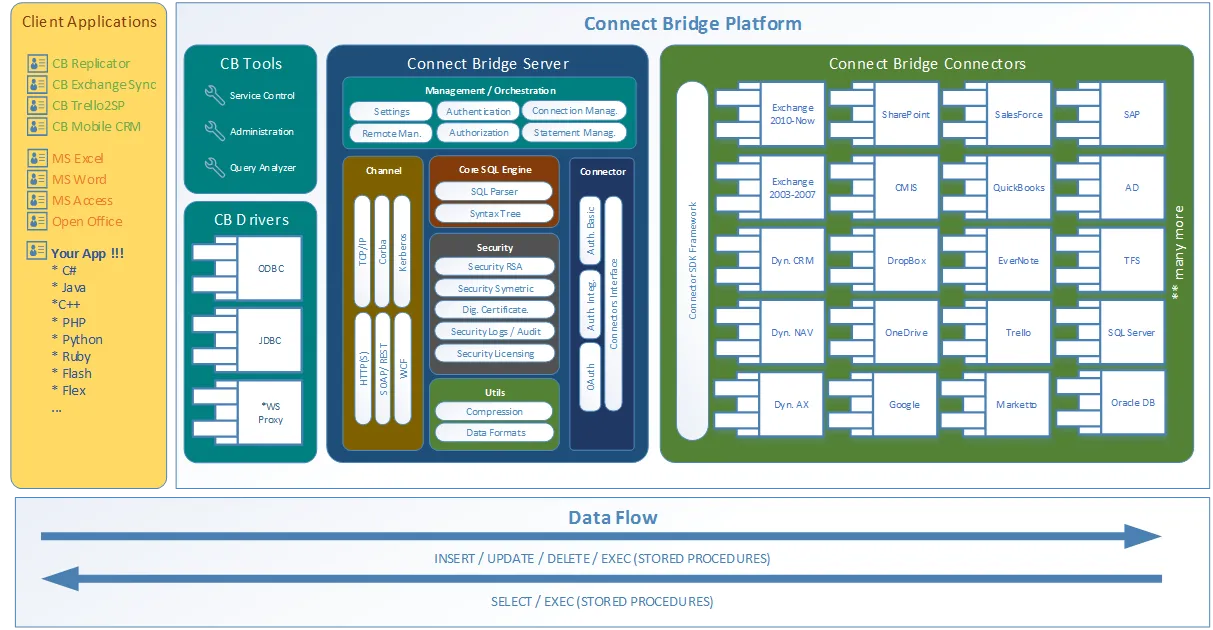
よくぞ聞いてくれました! Connect Bridge は、Connecting Softwareが開発した統合プラットフォームで、ODBCドライバ、JDBCドライバ、Webサービスを通じて、あらゆるソフトウェアを接続することができます。このツールのアーキテクチャの概要は、このクライアント・サーバーシナリオ図にあります。
 (opens in a new tab)
Connect Bridge 統合プラットフォームアーキテクチャ
アーキテクチャ図にあるように、このツールはPythonスクリプト内からMicrosoft SharePointのデータにアクセスできるだけでなく、Microsoft ExchangeやMicrosoft Dynamics CRMとの間でデータを取得/出力することもできます。
今回の作業の目的は、Connect Bridgeを経由してSharePointと会話するためのPythonスクリプトを作成することでした。
弊社ではSharePointを使用していますが、同様のロジックで マイクロソフト Exchange またはSalesforceやDynamicsのようなCRMへ。
はじめに...
では、このチュートリアルを始めましょう今回の目的は、SharePointインスタンスにアクセスするシンプルなPythonスクリプトを作成することです。SharePointインスタンスは既に存在していると仮定します(ログイン認証が手元にあることを確認してください)。以下は、あなたが従うべき簡単な手順です。
1.リクエスト フリートライアル とConnect Bridgeをインストールします。
2. インストール Windows用のPython ver. 3.14以上。なお、私のスクリプトの作成、実行、およびデバッグを容易にするため、以下を使用しています。 リクリップス 12.0.1 と pydev プラグインを使用しますが、もちろんこれは任意です。VS Code や PyCharm など、どのエディタでも問題ありません。.
3. インストール パイodbcモジュール 5.3.0+
4. Connect Bridge Management Studioを実行し
4.1. SharePointのアカウントを追加する(Accounts - Add account)。ここで、先ほどの認証情報が必要になります。
4.2. を開く 新規クエリ オプションを指定し コネクションブラウザ.を検索します。 SharePointコネクタ と表示されるまで開いてください。 DefaultConnection.その上で右クリックし 接続文字列の取得.次に、ODBC接続文字列をコピーします。スクリプトに渡すために必要です。
4.3. 新規クエリ]オプションを使用して、SharePointで必要なものにアクセスするクエリをテストしてください。ここでは、クエリの例を示しますが、ここには、SharePointで探しているものを入れてください。をクリックしたら 新規クエリを開いてください。 コネクションブラウザ.を検索します。 SharePointコネクタ と表示されるまで開いてください。 テーブル オプションを使用します。スキーマにSite_Pagesという “テーブル ”が含まれていることがわかります。
SELECT UniqueId, ContentType, Created, Modified, ContentVersion FROM Site_Pages LIMIT 10;
を選択すると、SharePointの最初の10件が選択されます。 サイトページ のリストが表示されます。一見、データベースを直接使っているように見えますが、そうではないことに注意が必要です。
Connect BridgeはAPIにアクセスし、それをあたかもデータベースであるかのように表示しています。クエリが準備できたら、それをコピーしておいてください。このクエリはスクリプトに渡す必要もあります。.
ハンズオンスクリプト!
このソリューションの中核であり、同時に唯一のファイルはCBQuery.pyです。ソースコード全体は以下の通りです。コアとなるソリューションを示す70-92行に注目してください。このスクリプトがどのように動作するかの完全な説明は以下の通りです。
#!/usr/bin/env python3
# エンコーディング: utf-8
"""
CBQuery -- SharePoint からのデータ取得および SharePoint へのデータ書き込み

Connect Bridge ODBC ドライバを介して SQL クエリを実行します。

@author:   Ana Neto
@created:  2019-07-04
@updated:  2026-10-14
"""

import sys
from argparse import ArgumentParser
from contextlib import closing

import pyodbc


def main():
    parser = ArgumentParser(description=__doc__)
    parser.add_argument("connstr", help="Connect Bridge Management Studio からの ODBC 接続文字列")
    parser.add_argument("query", help="実行する SQL クエリまたは EXEC ステートメント")
    args = parser.parse_args()

    try:
 # 処理終了時に接続を閉じる
 with closing(pyodbc.connect(args.connstr)) as conn:
 cursor = conn.cursor()
 cursor.execute(args.query)

 if cursor.description is None:
                # 結果行が返されませんでした
 conn.commit()
 print("OK")
 else:
 for row in cursor:
 print(row)
 conn.commit()

 return 0

 except KeyboardInterrupt:
 return 130
    except pyodbc.Error as err:
 print(f"ODBC エラー: {err}", file=sys.stderr)
 return 2


if __name__ == "__main__":
    sys.exit(main())
スクリプトが何をしているのかを説明します。
- 仝
argparseblock は 2 つのコマンドライン引数を読み込み、,connstr(ODBC接続文字列)およびクエリ. - 変数 `connstr` には、ODBC 接続を作成するために `pyodbc` モジュールに渡す ODBC 接続文字列が格納されています(これは
コン変数)。この接続はcontextlib.closing, そのため、たとえエラーが発生した場合でも、ブロックの終了時には常に閉じられます。. - 次のステップとして、`conn` に格納されている接続を使用して、データベースカーソルを開きます。
- SQLクエリを実行します(これは、query という名前のコマンドライン引数を通じて渡されたクエリです)。
- ステートメントが行を返す場合、カーソルをループさせて結果を1行ずつ読み取り、各行を出力します。このデモではこの方法を採用しましたが、出力形式はどのようなものでも構いません……XML、JSON、CSV……あるいはその他のデータ交換形式にフォーマットすることも可能です。 また、その後のコードで生のデータ行オブジェクトをそのまま使用して、独自の処理を行うことも可能です。.
- ステートメントが0行を返した場合(INSERT、EXEC)、スクリプトは「OK」と表示します。.
- どちらの場合もトランザクションは明示的にコミットされるため、INSERT文やストアドプロシージャによって行われた変更は保存されます。.
- ODBC エラーは stderr に出力され、スクリプトはコード 2 で終了します。Ctrl+C を押すとコード 130 で終了し、正常終了の場合はコード 0 で終了します。.
CBQuery.pyスクリプトの実行
CBQuery.py は、2つの位置指定型コマンドライン引数(connstr と query)を受け付けます。.
前述の通り(の4番目の項目)、これらをConnect Bridge Management Studioからコピーする必要があります。 始めるには セクション)。
次に、次のようにスクリプトを実行してください:
python CBQuery.py "" "SELECT UniqueId, ContentType FROM Site_Pages LIMIT 10;"それでは、SharePointに連絡先リストを作成し、そのリストに連絡先を追加すると仮定しましょう。.
基本的には同じ手順に従いますが、クエリを「ストアドプロシージャ」を使用するように変更する必要があります。 繰り返しになりますが、この「ストアドプロシージャ」は実際にはAPIを介してSharePointにアクセスしますが、指定したSharePointにデータを格納します。実行する必要があるクエリは以下の通りです:
EXEC SP_CREATE_TABLE 'MyContacts', 'このテーブルは Connect Bridge を使用して作成されました', true, 'Contacts';パラメータは、順に次のとおりです:新しいリストの名前(マイコンタクト); 説明; ブール値のフラグ (真の); および、その基礎とするSharePointリストテンプレート(連絡先).
このクエリは、新しいSharePointリスト(MyContacts)を作成し、SharePointページのクイック起動バーに表示される説明文を付けます。
次に、SharePoint スキーマの Connect Bridge ODBC スキーマリフレクションを更新するために、以下のクエリを実行する必要があります。これにより、新しい「テーブル」が ODBC クライアントから認識されるようになります。(このプロシージャには引数は必要ありません。)
EXEC SP_UPDATE_SCHEMA;この時点で連絡先リストに連絡先エントリーを挿入することができます。
INSERT INTO MyContacts (FirstName, LastName) VALUES ('Ana', 'Neto');これで、SharePoint UIに当社のエントリと新しいSharePointリストが表示されるようになるはずです。
以下のクエリを実行することで、先ほど作成したエントリを選択することができます。
SELECT FirstName,LastName FROM MyContacts共有ドキュメントをアップロードするには、既存のSharePointリスト「Documents」と、「ストアドプロシージャ」SP_INSERT_SHAREDDOCUMENTを使用します。このプロシージャが受け取るパラメータは以下の通りです:
- 共有ドキュメントのテーブル名
- ファイル名
- フォルダ(サーバー上の相対パス)
- MIMEタイプ
- ファイルのデータ(Base64エンコード済み。以下の例では、,
SGVsbG8gV29ybGQ=(単に「Hello World」というテキストです)
以下のステートメントを実行することで、ドキュメントを挿入することができます。
EXEC SP_INSERT_SHAREDDOCUMENT
    'Documents',
    'hello2.txt',
    '/Shared Documents/NewFolder',
    'text/plain',
    'SGVsbG8gV29ybGQ=';
あらかじめフォルダの有無を確認したい場合は、以下のステートメントを実行してください。パラメータには、ドキュメント ライブラリ名と相対フォルダ パスを指定します。
EXEC SP_ENSURE_FOLDER_PATH
    'Documents',
    '/NewFolder';
SP_INSERT_SHAREDDOCUMENTを実行した後、ステートメントを実行することで、“Documents ”テーブル内のドキュメントの存在を確認することができます:
SELECT Id,Name FROM Documents;また、次のステートメントを実行することで、特定のドキュメント ライブラリにある特定のドキュメントのバイナリ コンテンツをダウンロードすることもできます。 以下です。そのパラメータは、ライブラリ名と、上記の SELECT によって返されるドキュメントの ID です:
EXEC SP_SAVE_SHAREDDOCUMENT_BY_ID 'Documents', 2;この時点で、SharePointのUI上で共有ドキュメントが存在するかどうかを確認できます。.
制約
これまでのところ、ODBC用のLinuxクライアントライブラリが利用できないため(そもそもそれが可能かどうかさえ不明ですが)、Connect BridgeツールはWindowsオペレーティングシステム上でのみ使用することができています。そのため、Pythonスクリプトのテストは必ずWindowsマシンで行ってください。.
結論
Connect Bridge統合プラットフォームを使用すれば、PythonからSharePointのデータに簡単にアクセスできることを確認しました。 さて、この記事で紹介した内容が、Microsoft Dynamics CRMやMicrosoft Exchangeでも可能だと想像してみてください! はい、Connect Bridgeを使えばこれが可能であり、その方法も同様です。.

質問がある場合は誰に連絡すればいいですか?
記入例 アナ・ネト, テクニカルアドバイザー Connecting Softwareにて。
"私は1997年からソフトウェア・エンジニアであり、最近は書くことと人前で話すことが好きです。この記事について質問やコメントはありますか?ご意見・ご感想をお待ちしております!"
Comments 1
わかりやすい説明ありがとうございました